
科目组合
计算机: 数据结构 、计算机组成原理 、操作系统 、计算机网络
答题情况分析报告


给定二叉树如右图所示。设 N 代表二叉树的根,L 代表根结点的左子树,R 代表根结点的右子树。若遍历后的结点序列是 3,1,7,5,6,2,4,则其遍历方式是()。

A.LRN B.NRL C.RLN D.RNL


该方法是一种局部贪心算法,它在每一步只考虑了从当前顶点出发到下一个顶点的局部最短距离(边权最小),而没有考虑到这个局部选择可能会导致后续的路径代价剧增。因此,局部最优的选择无法保证全局最优,上述方法无法正确求解最短路径问题。
假设存在一个带权有向图(无向图同理),包含初始顶点 SS,目标顶点 TT,以及两个中间顶点 AA 和 BB。各边的权值如下:
-
S→AS→A 的权值为 1
-
S→BS→B 的权值为 5
-
A→TA→T 的权值为 100
-
B→TB→T 的权值为 1
按照题目中的方法执行过程如下:
-
初始状态:最短路径集合 P={S}P={S},当前顶点 u=Su=S。
-
第一次选择:从 SS 出发,寻找离 SS 最近且不在 PP 中的顶点。
SS 到 AA 的距离是 1;SS 到 BB 的距离是 5;因为 1<51<5,算法会选择顶点 AA;将 AA 加入路径,当前顶点更新为 u=Au=A;此时路径为 S→AS→A。 -
第二次选择:从 AA 出发,寻找离 AA 最近且不在 PP 中的顶点。
目前不在 PP 中的相关顶点只有 TT(BB也还在,但边 A→TA→T 和 A→BA→B 没有直接连接,假设只考虑有直接连接的);AA 到 TT 的距离是 100;算法选择顶点 TT;将 TT 加入路径,当前顶点更新为 u=Tu=T。 -
结束:当前顶点 u=Tu=T 已经是目标顶点,算法结束。
算法求得的路径为: S→A→TS→A→T,总距离为 1+100=1011+100=101。
真正的最短路径为: S→B→TS→B→T,总距离为 5+1=65+1=6。
评分及理由
(1)得分及理由(满分10分)
得分:10分。
理由:
- 学生正确判断出该方法不能求得最短路径,结论与标准答案一致。
- 学生准确指出该方法属于局部贪心,每一步只选择当前顶点到下一顶点的最短边,无法保证全局最短路径,算法分析正确。
- 学生构造了一个带权图反例:S→A权值为1,S→B权值为5,A→T权值为100,B→T权值为1,并按照题目方法得到路径S→A→T,总代价101,而真正最短路径为S→B→T,总代价6,能够有效说明该方法不一定能得到最短路径。
- 虽然学生举的例子与标准答案给出的图不同,但逻辑正确,满足“思路正确不扣分”的要求。
- 未发现影响结论的逻辑错误或计算错误,因此不给扣分。
题目总分:10分

(1) 算法的基本设计思想
由于单链表只能从头到尾单向遍历,无法从尾部回溯,为了实现尽可能高效(即尽可能只遍历一次链表)的查找,可以采用双指针(快慢指针)的思想。
基本思路是:定义两个指针 p(快指针)和 q(慢指针),初始时均指向链表的第一个实际数据结点(即 list->link)。首先让快指针 p 沿着链表向前移动 kk 步。如果在此过程中 p 变为 NULL,说明链表长度不足 kk,查找失败。如果 p 成功移动了 kk 步,则让 p 和 q 同步向后移动。由于 p 和 q 之间的距离始终保持为 kk,当快指针 p 走到链表末尾(即 p == NULL)时,慢指针 q 正好指向倒数第 kk 个结点。该算法时间复杂度为 O(n)O(n),空间复杂度为 O(1)O(1)。
(2) 算法的详细实现步骤
#include <stdio.h>

// 单链表结点结构定义
typedef struct Node {
    int data;
    struct Node *link;
} Node;

/**
 * 查找带头结点单链表中倒数第k个位置的结点
 * @param list 头指针
 * @param k 倒数位置(正整数)
 * @return 查找成功返回1并输出data,否则返回0
 */
int findKthFromEnd(Node *list, int k) {
    // 1. 边界条件判断:空表或k不合法
    if (list == NULL || list->link == NULL || k <= 0) {
        return 0;
    }

    // 2. 初始化快慢指针,均指向第一个实际数据结点
    Node *p = list->link; // 快指针
    Node *q = list->link; // 慢指针

    // 3. 快指针先向前移动 k 步
    for (int i = 0; i < k; i++) {
        if (p == NULL) {
            return 0; // 链表长度不足 k,查找失败
        }
        p = p->link;
    }

    // 4. 快慢指针同步向后移动
    while (p != NULL) {
        p = p->link;
        q = q->link;
    }

    // 5. 此时 q 正好指向倒数第 k 个结点
    printf("%d\n", q->data); // 输出结点的data域的值
    return 1;                // 查找成功
}
-
边界检查:若头指针
list为空,或链表为空(list->link == NULL),或 k≤0k≤0,直接返回 0。 -
初始化:声明两个结点指针
p和q,均指向链表的第一个数据结点:p = list->link; q = list->link;。 -
快指针先行:让快指针
p向后移动 kk 个位置。在循环移动过程中,若p提前变为NULL,说明链表长度小于 kk,查找失败,返回 0。 -
同步移动:若
p成功走了 kk 步,则开启循环,让p和q同时向后移动(p = p->link; q = q->link;),直到p == NULL为止。 -
输出结果:此时慢指针
q指向的结点即为倒数第 kk 个结点。输出q->data的值,并返回 1。
评分及理由
(1)得分及理由(满分5分)
得5分。学生正确采用了双指针(快慢指针)思想,明确指出通过一趟遍历定位倒数第k个结点,并分析了算法时间复杂度O(n)、空间复杂度O(1),与标准答案的基本设计思想一致,表述完整,思路正确。
(2)得分及理由(满分5分)
得5分。学生给出的详细实现步骤完整:先初始化p、q指向第一个实际结点,快指针p先移动k步,若中途为空则失败;之后p、q同步后移,直到p为空,此时q指向倒数第k个结点,最后输出并返回1。步骤逻辑清晰,边界情况也有考虑,符合标准答案要求。
(3)得分及理由(满分5分)
得5分。学生使用C语言实现了算法,数据结构定义正确,关键操作有注释,算法采用一趟扫描,空间复杂度O(1),逻辑正确。返回值与输出要求也符合题目要求。虽然题目中“详细实现步骤”部分混入了代码,但整体仍能看出其步骤描述,代码实现本身正确,因此不扣分。
题目总分:5+5+5=15分
在中断方式下,CPU用于该外设I/O的时间占整个CPU时间的百分比是 2.5%。
在DMA方式下,CPU用于该外设I/O的时间占整个CPU时间的百分比是 0.1%。
评分及理由
(1)得分及理由(满分4分)
学生写出最终答案为2.5%,与标准答案一致,结论正确,可得4分。但学生未给出计算过程,而题目要求“要求给出计算过程”,因此按严格评分可酌情扣分。考虑到本题为8分综合题,且问题明确要求给出计算过程,学生仅给结果、无过程,应扣除一定过程分。若按“结果正确但无过程”处理,可给2分。
(2)得分及理由(满分4分)
学生写出最终答案为0.1%,与标准答案一致,结论正确,可得4分。但同样未给出计算过程,题目要求给出计算过程,因此应扣除过程分。若按“结果正确但无过程”处理,可给2分。
题目总分:2+2=4分


-
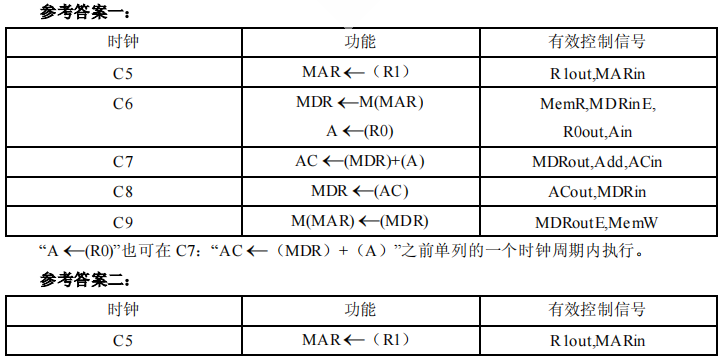
C5:取 R0 的值并暂存,同时计算有效地址
-
需要将 R0 的值送入 ALU 的输入端 A(
R0out, Ain)。 -
同时,为了后续访问主存,需要将 R1 的值(即主存地址)送入 MAR(
R1out, MARin)。 -
注意:这里将两个不冲突的操作合并在一个时钟周期内完成,以提高效率。
-
-
C6:从主存读取数据
-
根据 MAR 中的地址,从主存读取数据到 MDR(
MemR, MDRinE)。由于是读操作,需要给存储器发读命令,所以是MemR。
-
-
C7:执行加法运算
-
将 MDR 中的数据(即
((R1)))送入 ALU 的输入端(MDRout, ADD,假设 ALU 的另一输入端已由 Ain 锁存了 R0 的值),进行加法运算,并将结果暂存到 AC(ACin)。
-
-
C8:将结果写回主存
-
将 AC 中的结果送入 MDR(
ACout, MDRin)。 -
同时,需要将之前保存在 MAR 中的地址(R1 的值)重新送入 MAR(
R1out, MARin),因为 MAR 是地址锁存器,通常需要保持地址直到写操作完成。 -
注:有些设计会在 C5 后就保持 MAR 不变,但标准的数据通路通常需要显式给出地址输入。题目为了简化,这里可以合并写。
-
-
C9:写入主存
-
将 MDR 中的数据写入主存对应地址(
MemW, MDRoutE)。此时需要给存储器发写命令MemW。
-
评分及理由
(1)得分及理由(满分13分)
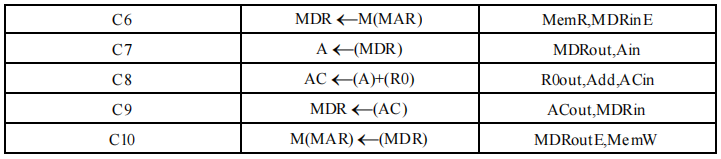
本题要求按表格形式列出指令执行阶段每个节拍的功能和有效控制信号。学生答案以分点说明形式给出,未严格按表格列出,但若控制信号和功能与时序正确,仍可给分。逐项评判如下:
- 时序安排:学生将执行阶段分为 C5~C9 共 5 个节拍,采用“C5 同时完成 R0out,Ain 和 R1out,MARin;C6 读主存;C7 做加法;C8 ACout,MDRin;C9 写主存”的方案。该方案对应参考答案一,思路正确,未增加节拍,不扣分。
- C5:学生给出“R0out, Ain”和“R1out, MARin”,即在同一节拍完成 R0 送 A 和 R1 送 MAR。参考答案一 C5 为“R1out,MARin”,C6 为“MemR,MDRinE, R0out,Ain”,即把 R0out,Ain 安排在 C6。学生的安排也将 R0 值暂存到 A,逻辑上可行,且不冲突,不扣分。
- C6:学生给出“MemR, MDRinE”,功能为“从主存读取数据到 MDR”。正确,不扣分。
- C7:学生给出“MDRout, ADD, ACin”,功能为“MDR 与 A 相加,结果送 AC”。但学生在此处遗漏了“Ain”已被 C5 锁存的前提说明,若按学生自述“ALU 的另一输入端已由 Ain 锁存了 R0 的值”,则逻辑可通。严格来说,若仅写“MDRout, ADD, ACin”而未体现 R0 参与运算,但学生已说明 A 中已锁存 R0,故不扣分。
- C8:学生给出“ACout, MDRin”,功能为“将 AC 结果送 MDR”。正确,不扣分。学生额外提到“重新送 MAR”并注明可合并写、有些设计保持 MAR 不变,但未实际列入有效控制信号,不影响答案正确性,不扣分。
- C9:学生给出“MemW, MDRoutE”,功能为“将 MDR 写入主存”。正确,不扣分。
- 表格形式:题目明确要求“用表格列出”,学生以文字分点列出,未采用表格。属于表述形式不符合要求,扣 1 分。
- 完整性与准确性:整体执行阶段功能和控制信号基本正确,无严重逻辑错误;但 C7 未显式写出 R0out 或 A 参与运算的控制信号,依赖前文说明。考虑到学生已解释 A 中已锁存 R0,且该方案与参考答案一等价,不另扣分。
综上,学生答案思路正确,控制信号基本正确,仅因未按表格形式作答扣 1 分。得分为 13 - 1 = 12 分。
题目总分:12分
semaphore mutex = 1; // 用于缓冲区的互斥访问
semaphore empty = N; // 缓冲区中空闲单元的数量
semaphore odd = 0;   // 缓冲区中奇数的数量
semaphore even = 0;  // 缓冲区中偶数的数量

// 进程 P1 (生产者)
void P1() {
    while (true) {
        int num = produce(); // 生成一个正整数
        P(empty);            // 申请一个空闲单元,若缓冲区满则阻塞
        P(mutex);            // 申请缓冲区的互斥访问权

        put(num);            // 将数据放入缓冲区

        V(mutex);            // 释放缓冲区的互斥访问权
        if (num % 2 != 0) {
            V(odd);          // 如果是奇数,增加奇数资源数量,唤醒可能等待的 P2
        } else {
            V(even);         // 如果是偶数,增加偶数资源数量,唤醒可能等待的 P3
        }
    }
}

// 进程 P2 (奇数消费者)
void P2() {
    while (true) {
        P(odd);              // 申请一个奇数资源,若没有奇数则阻塞
        P(mutex);            // 申请缓冲区的互斥访问权

        int num = getodd();  // 从缓冲区取出一个奇数

        V(mutex);            // 释放缓冲区的互斥访问权
        V(empty);            // 增加一个空闲单元,唤醒可能等待的 P1

        countodd(num);       // 统计奇数个数
    }
}

// 进程 P3 (偶数消费者)
void P3() {
    while (true) {
        P(even);             // 申请一个偶数资源,若没有偶数则阻塞
        P(mutex);            // 申请缓冲区的互斥访问权

        int num = geteven(); // 从缓冲区取出一个偶数

        V(mutex);            // 释放缓冲区的互斥访问权
        V(empty);            // 增加一个空闲单元,唤醒可能等待的 P1

        counteven(num);      // 统计偶数个数
    }
}
评分及理由
(1)得分及理由(满分7分)
该生作答整体思路正确,信号量定义和同步互斥机制与标准答案一致,伪代码结构清晰,能够正确实现三个进程对缓冲区的互斥访问以及按奇偶性同步消费。具体分析如下:
- 信号量定义正确:定义了 mutex=1 用于缓冲区互斥,empty=N 表示空闲单元数,odd=0 和 even=0 分别用于 P1 与 P2、P1 与 P3 之间的同步。含义说明清晰,符合标准答案。
- P1 逻辑正确:先 P(empty) 判断有空单元,再 P(mutex) 进入临界区,put 后 V(mutex) 释放缓冲区,然后根据奇偶性 V(odd) 或 V(even) 通知对应消费者。顺序正确,不会造成死锁。
- P2 逻辑正确:先 P(odd) 等待奇数,再 P(mutex) 进入临界区,getodd 后 V(mutex) 释放缓冲区,再 V(empty) 通知生产者,最后 countodd。顺序正确。
- P3 逻辑正确:与 P2 对称,先 P(even),再 P(mutex),geteven 后 V(mutex),V(empty),counteven。逻辑正确。
- 代码细节:学生代码中 P2 的 countodd(num) 和 P3 的 counteven(num) 传入了参数,而标准答案中未传参,但题目只要求“统计奇数/偶数个数”,传参不影响正确性,且属于合理实现。另外,学生使用了 while(true) 循环,符合进程反复执行的特点,标准答案省略了循环但隐含了重复执行,不扣分。
- 无逻辑错误:未发现死锁、互斥失效或同步遗漏等问题。信号量 P/V 操作顺序正确,符合操作系统同步互斥规范。
综上,该生作答完全正确,思路与标准答案一致,无逻辑错误,应给满分 7 分。
题目总分:7分
2362H:210 ns;1565H:100,000,220 ns;25A5H:210 ns
物理地址:254565H;理由:访问1565H时发生缺页中断。根据LRU算法,最近最少使用的页是页号2(因为刚刚访问过2362H,其页号为2),因此页号2被淘汰,其占用的物理帧254H被分配给页号1。所以页号1对应的物理地址为 254H×1000H+565H=254565H254H×1000H+565H=254565H。
评分及理由
(1)得分及理由(满分6分)
本小题满分6分。学生给出的三个访问时间为:2362H:210 ns;1565H:100,000,220 ns;25A5H:210 ns。
逐项判断:
- 2362H:页号为2,TLB初始为空,需访问TLB 10ns,未命中后访问页表100ns,得到页框号后访问内存100ns,合计210ns。学生答案正确,得2分。
- 1565H:页号为1,有效位为0,缺页。标准答案中缺页处理时间为10^8ns,已包含更新TLB和页表的时间;按照题目“缺页中断处理后,返回到产生缺页中断的指令处重新执行”,重新执行时仍需先访问TLB、再访问页表或直接TLB命中,最后访问主存。标准答案计算为10ns+100ns+10^8ns+10ns+100ns=100,000,220ns。学生答案与该结果一致,正确,得2分。
- 25A5H:页号为2。此时页2已在第一次访问后可能进入TLB;但第二次访问1565H发生缺页后,根据LRU淘汰的是页0,页2仍驻留。TLB中可能已有页2,因此TLB命中10ns后访问主存100ns,合计110ns。学生给出210ns,错误地把25A5H当作TLB未命中、又访问页表计算,多算了100ns。扣2分。
因此本小题得分为4分。
(2)得分及理由(满分2分)
本小题满分2分。学生给出的物理地址为254565H,理由为淘汰页号2,把页框254H分配给页号1。
该答案错误。访问序列为2362H、1565H、25A5H。访问1565H时发生缺页,此时内存中驻留页为页0和页2。根据LRU,最近最少使用的页面是页0,而不是页2,因为页2刚在2362H中被访问过。因此应淘汰页0,其页框号为101H,并将页框101H分配给页1。于是虚地址1565H的物理地址应为101565H。
学生淘汰页2并得到254565H,置换对象和物理地址均错误,不能得分。得0分。
题目总分:4+0=4分

\begin{array}{|c|c|c|c|}
\hline
\texttt{目的网络IP地址} & \texttt{子网掩码} & \texttt{下一跳IP地址} & \texttt{接口} \\
\hline
\end{array}
\]


 The road of your choice, you have to go on !
粤ICP备16082171号-1


